
Publications
2026
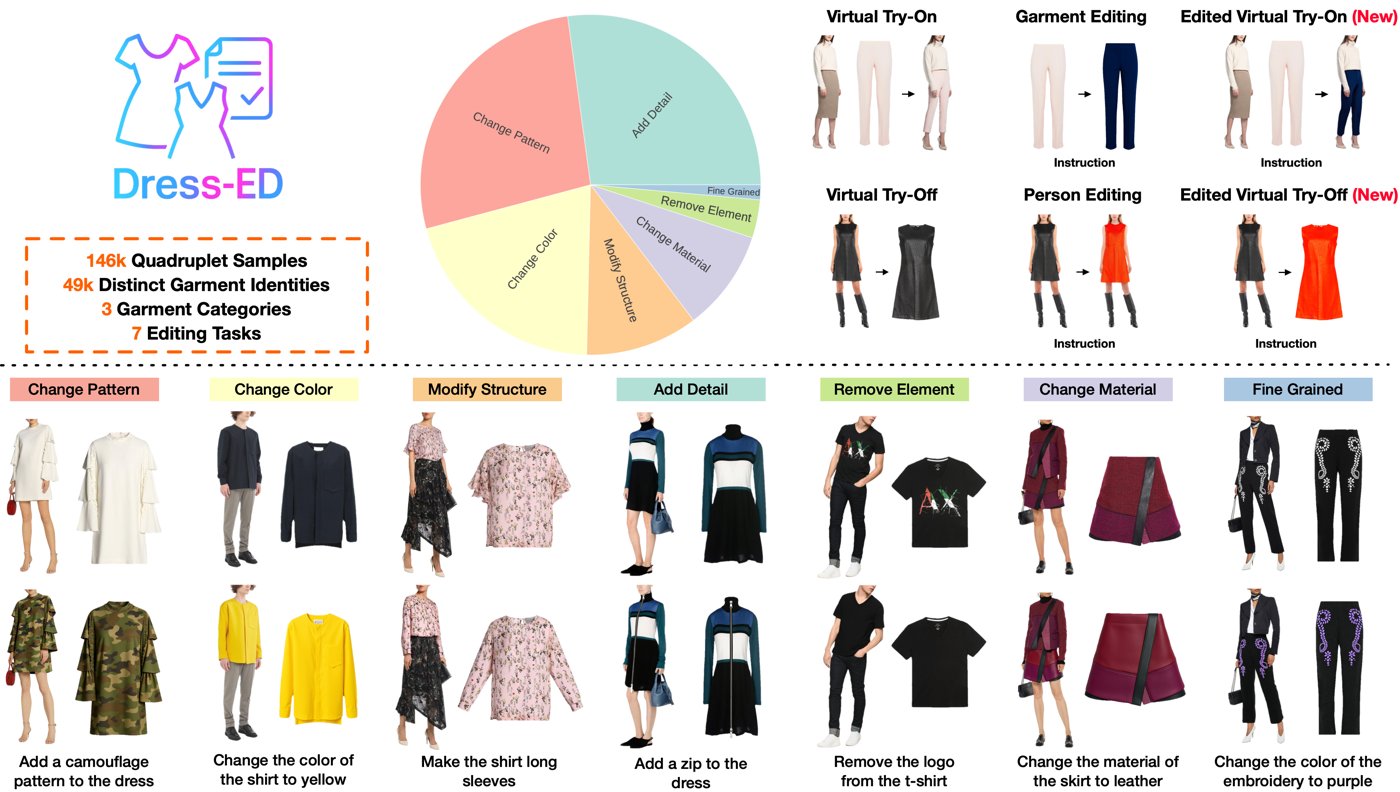
Dress-ED: Instruction-Guided Editing for Virtual Try-On and Try-Off
European Conference on Computer Vision (ECCV), 2026
The first benchmark unifying virtual try-on, try-off and text-guided garment editing: 146k verified quadruplets across three garment categories and seven edit types, built with a fully automated MLLM + diffusion curation pipeline.
@inproceedings{lobba2026dress,
  title     = {Dress-ED: Instruction-Guided Editing for Virtual Try-On and Try-Off},
  author    = {Davide Lobba and Fulvio Sanguigni and Bin Ren and Marcella Cornia and Rita Cucchiara and Nicu Sebe},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year      = {2026}
}
Inverse Virtual Try-On: Generating Multi-Category Product-Style Images from Clothed Individuals
International Conference on Learning Representations (ICLR), 2026
TEMU-VTOFF: virtual try-off across multiple garment categories — recovering clean, product-style images of what a person is wearing from a single photo.
@inproceedings{lobba2026inverse,
  title     = {Inverse Virtual Try-On: Generating Multi-Category Product-Style Images from Clothed Individuals},
  author    = {Davide Lobba and Fulvio Sanguigni and Marcella Cornia and Nicu Sebe and Rita Cucchiara},
  booktitle = {International Conference on Learning Representations (ICLR)},
  year      = {2026}
}
2025

Fashion-RAG: Multimodal Fashion Image Editing via Retrieval-Augmented Generation
International Joint Conference on Neural Networks (IJCNN), 2025
Retrieval-augmented fashion image editing: garments retrieved from a textual description condition the generation, editing what a person wears.
@inproceedings{sanguigni2025fashionrag,
  title     = {Fashion-RAG: Multimodal Fashion Image Editing via Retrieval-Augmented Generation},
  author    = {Fulvio Sanguigni and Davide Morelli and Marcella Cornia and Rita Cucchiara},
  booktitle = {International Joint Conference on Neural Networks (IJCNN)},
  year      = {2025}
}
2023

Diffusion Models for Earth Observation Use-cases
Big Data from Space (BiDS), 2023
One of the first diffusion-based approaches to image inpainting for remote-sensing imagery, developed at ESA Φ-Lab.
@inproceedings{sanguigni2023diffusion,
  title     = {Diffusion Models for Earth Observation Use-cases},
  author    = {Fulvio Sanguigni and Mikolaj Czerkawski and Lorenzo Papa and Irene Amerini and Bertrand Le Saux},
  booktitle = {Big Data from Space (BiDS)},
  year      = {2023}
}
* Equal contribution.